第10章
セグメントとロケーション・カウンター
2章では、セグメントを紹介しました。セグメントとは、コードまたはデータという1種類の内容を持つプログラムの領域で、TANRENがそれぞれ別々にメモリに配置するものです。この章では、セグメントについて詳しく説明します。TATARAがそれぞれのセグメントでアドレスを数える方法、セグメントを選び、そのアドレスを設定し、その中に領域を確保する疑似命令、関係のあるコードやデータをまとめておける名前付きセグメント、そして Tatara独自の機能で、変数どうしでメモリを共有できるトランジェント・データ・セグメントです。
10.1 ロケーション・カウンター
TATARAはセグメントをアセンブルしながら、それぞれの行が作るバイトを数えます(2章)。この数がロケーション・カウンター(location counter)です。ラベルは、その行でのロケーション・カウンターの値を持ち、式の中の$はその値を読みます(8章)。
ロケーション・カウンターは、セグメントごとに1つあります。ソースがセグメントを切り替えると、TATARAはいまのカウンターをしまっておき、もう一方のセグメントのカウンターを使います。戻ってきたときは、止まったところから続けます。次のソースでは、コードとデータが交互に書かれていますが、それぞれの種類は別々に数えられます。
                cseg
start:          ld      hl,count
                inc     (hl)
                dseg
count:          ds      1
                cseg
again:          ret
                dseg
total:          ds      2
TATARAのリスティングには、各行のアドレスが表示されます。
  0000'   21 00 00              start:          ld      hl,count
  0003'   34                                    inc     (hl)
                                                dseg
  0000'                         count:          ds      1
                                                cseg
  0004'   C9                    again:          ret
                                                dseg
  0001'                         total:          ds      2
againはコード・セグメントのオフセット4、つまりinc (hl)のすぐあとにあり、totalはデータ・セグメントのオフセット1、つまりcountのすぐあとにあります。アドレスのあとのアポストロフィーは、そのアドレスがリロケータブル、つまりTANRENが仕上げるセグメントの中のオフセットであることを示します(2章)。リスティングでは、コードとデータに同じ記号を使います。詳しくは18章で説明します。
10.2 コード、データ、アブソリュート
3種類のセグメントと、それぞれを選ぶ疑似命令を表10.1に示します。ソースはコード・セグメントから始まるので、自分のデータを持たないプログラムには、疑似命令はまったく必要ありません。
コードとデータを分けておくと、TANRENはデータをコードのすぐあと以外の場所に置くことができます。たとえば、ROMカートリッジは変数をRAMに置かなければなりません(33章)。TANRENは、ふつうはすべてのコード・セグメントを先に置き、そのあとにデータ・セグメントを置きます。その順序の詳細と、別のアドレスを選ぶオプションについては、24章で説明します。
アブソリュート・セグメント (absolute segment)では、どのアドレスも書いたとおりで、TANRENはそれを動かしません。4000hにあるROMカートリッジのヘッダーのように、決まったアドレスに置く必要があるコードやデータのためのものです。
警告. .COMのプログラムは0100hに読み込まれ、ひと続きのバイトの塊になっています。4000hのように、そこから遠いアブソリュートなアドレスを使うと、ファイルはその間のすべてを含むことになり、約16 KBの大きさになります。.COMのプログラムでアブソリュート・セグメントを使うのは、その理由がわかっている場合だけにしてください。
10.3 ORG
ORGは、いまのセグメントのロケーション・カウンターを設定します。アブソリュート・セグメントではオペランドはアドレスで、コード・セグメントとデータ・セグメントではセグメントの先頭からのオフセットです。
                aseg
                org     4000h
rom:            db      'AB'            ; at address 4000h
                cseg
                org     10h
code10:         nop                     ; 10h bytes into the code
ORGのオペランドは、TATARAがその行に最初に来たときにわかっていなければならないので、それより下で定義する名前は使えません。また、アブソリュートか、いまのセグメントの中のアドレスでなければなりません。データ・セグメントの中のアドレスは、コード・セグメントのロケーション・カウンターにはできないので、TATARAは8章のリロケーション・エラーを表示して止まります。
10.4 領域の確保:DS
DS(別名DEFS)は、ロケーション・カウンターを指定したバイト数だけ進め、それによって変数のための領域を確保します。
                dseg
buffer:         ds      128             ; 128 bytes
count:          ds      1               ; 1 byte
バイト数は、ORGのオペランドと同じように、アブソリュートで、最初の読み込みでわかっていなければなりません。DSがとるのはバイト数だけで、領域を埋める値のような2つ目のオペランドを書くとbad expression.になります。DSはバイトを何も書き出さず、ロケーション・カウンターを進めるだけです。そのため、プログラムは変数を読む前に値を入れておく必要があります。
10.5 名前付きセグメント
プログラムには、コード・セグメントもデータ・セグメントも、それぞれ 2つ以上置くことができます。CSEGやDSEGのあとに名前を書くと、名前付きセグメント(named segment)が選ばれます。
                cseg    music           ; all the music code
                dseg    strings         ; all the text
                dseg    variables       ; all the variables
名前付きセグメントは、同じ種類のふつうのセグメントと同じように働き、独自のロケーション・カウンターを持ちます。同じ名前を選ぶ行は、すべて同じセグメントに追加されます。そのため、1つの目的のためのコードを、いくつもの場所や、いくつものソース・ファイルに分けて書いても、最後には 1つにまとまります。TANRENは、リンクするすべてのモジュールから、同じ名前のセグメントをつなぎ合わせます。
次のソースでは、コード・セグメントとセグメントmusicが、それぞれ 2回選ばれています。
                cseg
main:           nop
                cseg    music
play:           nop
                nop
                cseg
more:           nop
                cseg    music
stop:           ret
シンボル表(19章)には、それぞれのセグメントがその大きさとともに表示され、それぞれのラベルが属するセグメントの下に表示されます。
CSEG - default code segment, 0002h bytes

0000h             main
0001h             more

music - named code segment, 0003h bytes

0000h             play
0002h             stop
TANRENは2つのセグメントを互いにどこに置くかわからないので、それぞれのセグメントは1つの値の種類になります(8.6節)。そのため、別々のセグメントにあるラベルどうしの差は、リロケーション・エラーとして受け付けられません。
10.6 トランジェント・データ・セグメント
たいていのプログラムには、プログラムの一部分でしか使わない変数があります。ユーザーが入力した行を読むルーチンは、読んでいる間、その行を入れるバッファーを必要とします。報告を表示するルーチンは、作っている行を入れるバッファーを必要とします。2つのルーチンが同時に動くことがなければ、2つのバッファーが同時に使われることもないので、同じメモリを使うことができます。.COMのプログラムがコードとデータを合わせて64 KB未満で収めなければならないMSXでは、この節約が大きな意味を持つことがあります。
ほかのアセンブラーでは、これはプログラマーの仕事です。プログラマーは、共有するアドレスを、たいていはEQUを使って手で計算し、変数の大きさが変わるたびに正しく直さなければなりません。Tataraでは、トランジェント・データ・セグメント (transient data segment)を使って、これを自動的に行います。
10.6.1 しくみ
トランジェント・データ・セグメントは、名前のあとにTRANSIENTという語を付けた名前付きデータ・セグメントです。その変数はグループ(group)に分けられ、それぞれのグループは名前を付けたGROUPの行で始まります。
                dseg    scratch,transient
                group   reading         ; used only while reading
inbuf:          ds      64
inlen:          ds      2
                group   writing         ; used only while writing
outbuf:         ds      32
outlen:         ds      2
規則はわずかです。
- グループの中では、変数はふつうのデータ・セグメントと同じように順に並び、重なることはありません。inbufとinlenは、同時に使うことができます。
- どのグループも、セグメントの先頭から始まります。outbufはinbufと同じアドレスにあります。
- セグメントの大きさは、いちばん大きいグループの大きさです。
- どの変数も、どこかのグループに入っていなければなりません。最初のGROUPより前にDSの行があると、エラーになります。
この例の4つの変数を、ふつうのデータ・セグメントとトランジェントなセグメントに置いたところを、図10.1に示します。ふつうのセグメントでは100バイトを使いますが、トランジェントなセグメントではグループreadingの大きさである66バイトで済み、writingの34バイトは何の負担にもなりません。
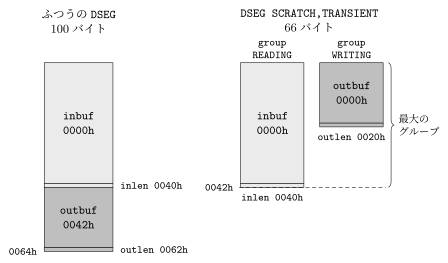
TATARAのシンボル表には、セグメントとそれぞれのグループが、その大きさと、グループの中の各変数のオフセットとともに表示されます。
scratch - named data segment, transient, group reading, 0042h bytes

0000h             inbuf
0040h             inlen

scratch - named data segment, transient, group writing, 0022h bytes

0000h             outbuf
0020h             outlen
10.6.2 安全に使うために
グループが表すのは、どの変数が同時に使われるかということだけです。それ以外はプログラマーの責任です。TATARAはプログラムの流れを追って、2つのグループが同時に使われないことを確かめたりはしません。
警告. あるグループの変数は、同じセグメントのほかのすべてのグループで同じオフセットにある変数と、同じアドレスを持ちます。一方に書き込むと、ほかのものが壊れます。writingを使うルーチンが、まだ表示していない行がoutbufに残っている間にreadingを使うルーチンを呼び出すと、ユーザーが入力した行でその行が上書きされてしまいます。互いに使っている間も残っていなければならない変数は、同じグループに入れるか、別々のトランジェント・セグメントに入れるか、ふつうのデータ・セグメントに入れてください。
規則を補う点が2つあります。
- 互いに重なるのは、1つのトランジェント・セグメントのグループどうしだけです。別々のセグメントがメモリを共有することはないので、交代で動くルーチンの組ごとに、トランジェント・セグメントを1つずつ持つことができます。
- グループの名前はグローバルです。別のモジュールにある同じセグメントの同じ名前のグループは同じグループで、TANRENがそれらをつなぎ合わせます。これを使った複数のモジュールからなるプログラムは、29章で説明します。
別々のグループにあるラベルは、互いに引き算することができません。どちらも、もう一方の位置について何も示さないからです。TATARAはリロケーション・エラーを表示します。
10.7 メッセージ
セグメントについてのメッセージを、それぞれの原因となる行とともに表10.2に示します。
行 |
メッセージ |
dseg vars,forever |
bad ASEG, CSEG or DSEG line. |
dsegと17文字の名前 |
a segment or group name may be at most 16 characters. |
dseg
varsのあとの |
this segment was declared differently before. |
コード・セグメントの中の |
GROUP needs a name, no label, and a transient DSEG. |
| this transient DSEG needs a GROUP first. |
|
dw
second-first |
relocation error - a segment-relative value is not allowed here. |
org
v |
relocation error - a segment-relative value is not allowed here. |
プログラムに置けるセグメント、グループ、外部の名前の数には限りがあり、それを超えるとtoo many segments, groups or externals.と表示されます。その限度は付録Eに一覧があります。